Todos los proyectos

Modelo de clasificación- Titanic

El proyecto busca construir un modelo de clasificación para predecir si un pasajero del Titanic sobrevivió o no, usando redes neuronales. Para ello, se parte del dataset titanic.csv que contiene datos demográficos y de viaje de los pasajeros.

  • PassengerId: Un identificador único para cada pasajero.
  • Survived: Indica si el pasajero sobrevivió (1) o no (0).
  • Pclass: Clase del boleto del pasajero (1 = Primera, 2 = Segunda, 3 = Tercera).
  • Name: Nombre del pasajero.
  • Sex: Sexo del pasajero (male = masculino, female = femenino).
  • Age: Edad del pasajero en años. Puede contener valores nulos.
  • SibSp: Número de hermanos/esposos a bordo del Titanic.
  • Parch: Número de padres/hijos a bordo del Titanic.
  • Ticket: Número del boleto del pasajero.
  • Fare: Tarifa del pasajero.
  • Cabin: Número de cabina del pasajero. Puede contener valores nulos.
  • Embarked: Puerto de embarque del pasajero (C = Cherburgo, Q = Queenstown, S = Southampton).

Problema de clasificación con redes neuronales.

Consignas

En base al set de datos “titanic.csv” realizar las siguientes tareas que comprenden un proyecto de problema de clasificación con redes neuronales:

    1. Chequear si en la base existen datos nulos, en caso de que existan, considerar si es necesario reemplazar los nulos por un valor o desestimar la variable dependiendo de la cantidad de nulos en la misma.
    2. Chequear por outliers, en caso de que los haya, excluirlos.
    3. Realizar la transformación de las variables categóricas, para que sean categóricas numéricas o dummy.
    4. Realizar análisis exploratorio de datos (EDA).
    5. Separar en subconjuntos de entrenamiento y de prueba.
    6. Entrenar el modelo de clasificación con redes neuronales.
    7. Exponer los resultados del modelo.
    8. Exponer el modelo final utilizado describiendo porque cree que es el mejor para la predicción del valor de futuras observaciones de la variable dependiente.

Respuestas

Consola:
df.isnull().sum()
Consola:
df[‘Age’].fillna(df[‘Age’].median(), inplace=True)
Consola:
df.drop(‘Cabin’, axis=1, inplace=True)
Consola:
df[‘Embarked’].fillna(df[‘Embarked’].mode()[0], inplace=True)

Se encontró nulos en las columnas de «Age», «Embarked» y «Cabin».

  • Para la columna «Age» rellenamos con la media.
  • Para «Cabin» desestimamos la columna.
  • Para «Embarked» repetimos la moda.

Luego corrimos nuevamente la detección de nulos y confirmamos que ya no teniamos.

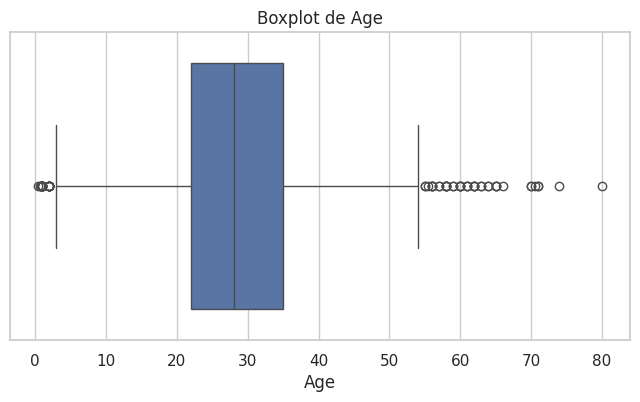
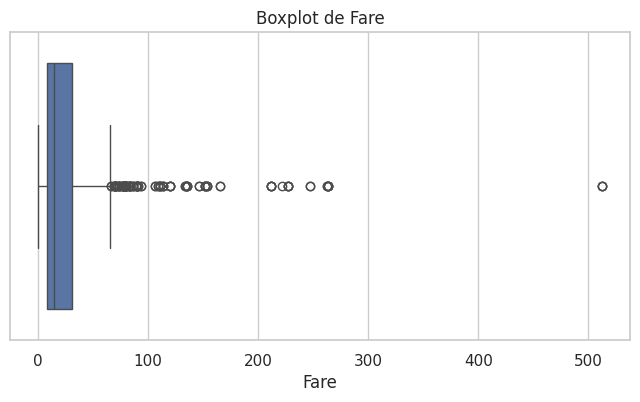
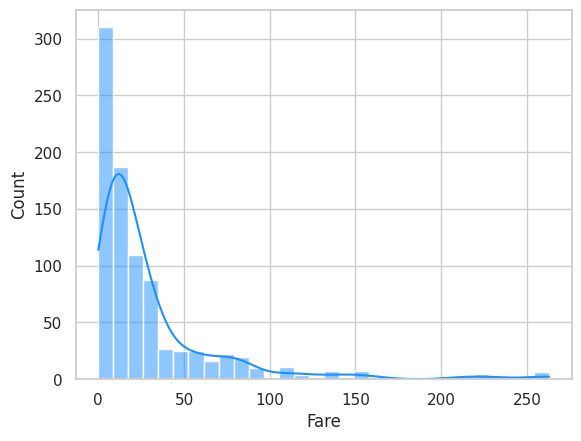
Detecté un outlier en «Fare» como en 500, asi que lo bajé a menor a 300. Para la edad si bien noté un numero alto como 80, no lo consideré tan alejado a otros datos, asi que lo mantuve.

Consola:
# Ajustar estilo
sns.set(style=»whitegrid»)

# Gráfico para ‘Age’
plt.figure(figsize=(8, 4))
sns.boxplot(x=df[‘Age’])
plt.title(‘Boxplot de Age’)
plt.show()

# Gráfico para ‘Fare’
plt.figure(figsize=(8, 4))
sns.boxplot(x=df[‘Fare’])
plt.title(‘Boxplot de Fare’)
plt.show()
Consola:
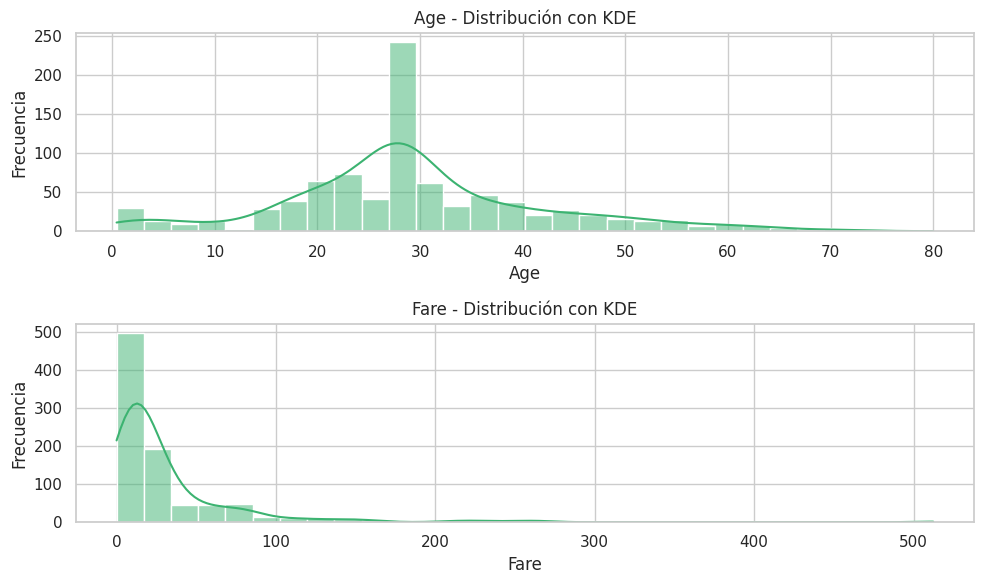
def univariate_analysis_titanic(data, columns):
    plt.figure(figsize=(10, len(columns) * 3))  # Ajuste dinámico según cantidad de columnas

    for i, column in enumerate(columns, 1):
        plt.subplot(len(columns), 1, i)
        sns.histplot(data[column], kde=True, bins=30, color=’mediumseagreen’)
        plt.title(f'{column} – Distribución con KDE’)
        plt.xlabel(column)
        plt.ylabel(‘Frecuencia’)

    plt.tight_layout()
    plt.show()

columns_to_analyze = [‘Age’, ‘Fare’]
univariate_analysis_titanic(df, columns_to_analyze)
Consola:
sns.histplot(df[df[‘Fare’]<300][‘Fare’], kde=True, bins=30, color=’dodgerblue’)
Consola:
numerical_columns = df.select_dtypes(include=[‘int64’, ‘float64’]).columns.tolist()
non_numerical_columns = df.select_dtypes(include=[‘object’]).columns.tolist()

print(«\nNumerical Columns:», numerical_columns)
print(«Categorical Columns:», non_numerical_columns)
Consola:
# Defino los diccionarios de mapeo
sex_map = {‘female’: 0,
           ‘male’: 1}

embarked_map = {‘C’: 1,
                ‘Q’: 2,
                ‘S’: 3}

# para no modificar original
df_mapeado = df.copy()

# Aplico los mapeos
df_mapeado[‘Sex’] = df_mapeado[‘Sex’].map(sex_map)
df_mapeado[‘Embarked’] = df_mapeado[‘Embarked’].map(embarked_map)

df_mapeado.head()
Análisis
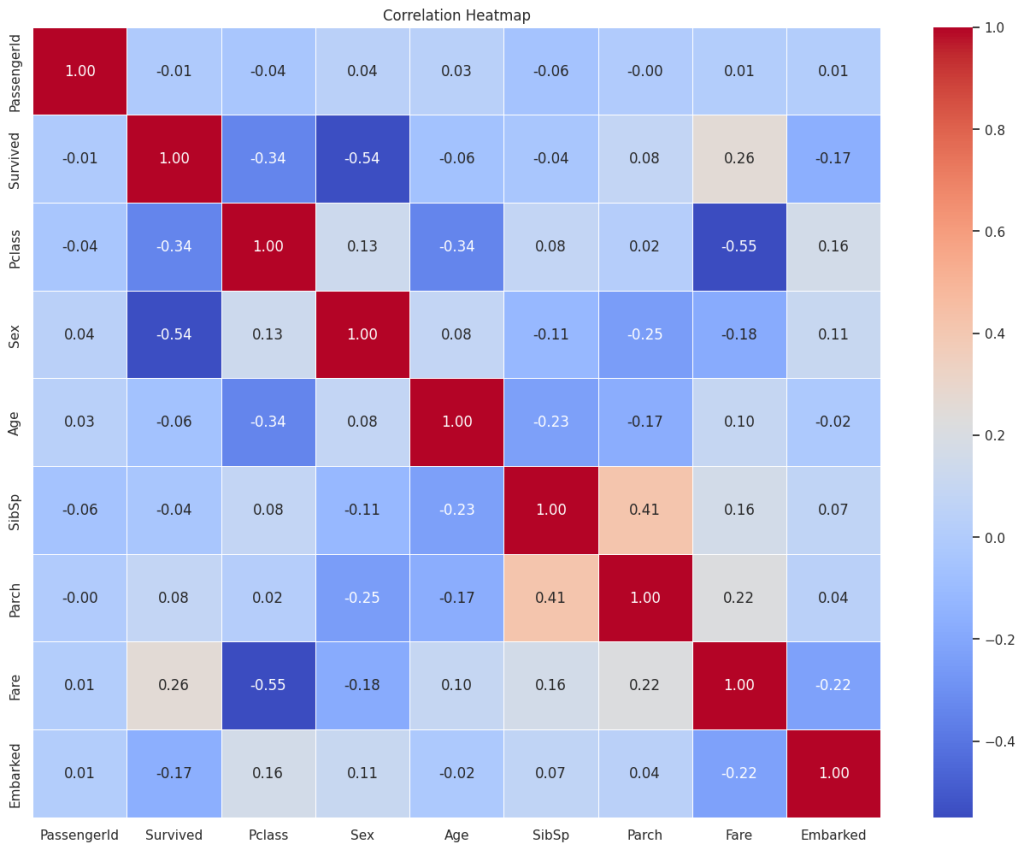
  • PClass y Fare: Tiene sentido, mientras mas alta la clase del pasajero mayor el precio del boleto.
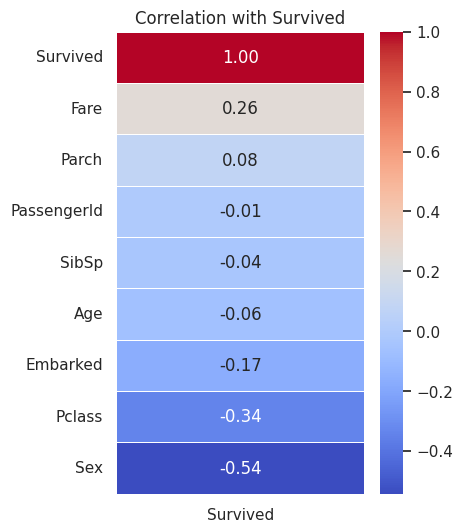
  • PClass y Survived: Mientras mayor clase mas probabilidad de sobrevivir.
  • Sex y Survived tienen una relacion alta, esto habla de que las mujeres tenían más chances de sobrevivir.
Consola:
df_numeric = df_mapeado.select_dtypes(include=[‘int64’, ‘float64’])
corr_matrix = df_numeric.corr()


# Plotting the heatmap
plt.figure(figsize=(16, 12))
sns.heatmap(corr_matrix, annot=True, cmap=’coolwarm’, fmt=’.2f’, linewidths=0.5)
plt.title(‘Correlation Heatmap’)
plt.show()
Consola:
target_variable = ‘Survived’
target_corr = corr_matrix[[target_variable]].sort_values(by=target_variable, ascending=False)

plt.figure(figsize=(4, 6))
sns.heatmap(target_corr, annot=True, cmap=’coolwarm’, fmt=’.2f’, linewidths=0.5)
plt.title(f’Correlation with {target_variable}’)
plt.show()
Consola:
# 1. Elegimos las features más relevantes
features = [‘Sex’, ‘Pclass’, ‘Fare’]
target = ‘Survived’

# 2. Dividimos entre X (features) e y (objetivo)
X = df_mapeado[features]
y = df_mapeado[target]

# 3. Separar en entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(
    X, y, train_size=0.8, random_state=42
)

# 4. Escalar
scaler = RobustScaler()

X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

X_train_scaled_df = pd.DataFrame(X_train_scaled, columns=features)
X_test_scaled_df = pd.DataFrame(X_test_scaled, columns=features)

# Mostrar resultado
print(X_train_scaled_df.head())
Consola:
# Modelado
#configuro el modelo de clasificacion
modelo = MLPClassifier(
                hidden_layer_sizes=(10,10),
                learning_rate_init=0.01,
                solver = ‘adam’,
                max_iter = 1000,
                random_state = 123 )
Consola:
#Entreno el modelo configurado previamente
modelo.fit(X=X_train_scaled, y=y_train)
Consola:
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report

# 1. Hacer predicciones con el modelo entrenado sobre el set de prueba
prediction = modelo.predict(X_test_scaled)

# 2. Calcular precisión (score) en entrenamiento y prueba
train_score = modelo.score(X_train_scaled, y_train)
test_score = modelo.score(X_test_scaled, y_test)

print(f»Train Score: {train_score*100:.2f}%»)
print(f»Test Score: {test_score*100:.2f}%»)

# 3. Calcular Accuracy usando sklearn
accuracy = accuracy_score(y_test, prediction)
print(f»Accuracy: {accuracy*100:.2f}%»)

# 4. Matriz de confusión
conf_mat = confusion_matrix(y_test, prediction)
print(«Confusion Matrix:\n», conf_mat)

# 5. Reporte detallado de clasificación
print(«Classification Report:»)
print(classification_report(y_test, prediction))
Consola:

Razones por las que este modelo es el mejor para la predicción

Buen desempeño con un conjunto reducido de variables. Usamos features clave: sexo, clase de pasajero y precio del pasaje, que son variables con alta correlación con la supervivencia. Con estas variables y la arquitectura seleccionada, el modelo alcanzó una precisión cercana al 80%, un buen indicador de capacidad predictiva.

Conclusión

El modelo es adecuado para predecir futuras observaciones de la variable dependiente en base a las variables incluidas.

Si bien el desempeño es bueno, se puede mejorar incluyendo más variables, realizando ajuste de hiperparámetros o probando otros modelos.

Para el contexto actual y los datos disponibles, este modelo es el más conveniente por su simplicidad.

Consola:
predicciones = modelo.predict(X_test_scaled)
accuracy = accuracy_score(y_test, predicciones)
print(f»Accuracy: {accuracy*100:.2f}%»)
Consola:
matriz_confusion = confusion_matrix(y_test, predicciones)
print(«Matriz de Confusión:\n», matriz_confusion)
Consola:
print(classification_report(y_test, predicciones))
Consola:
sns.heatmap(matriz_confusion, annot=True, fmt=’d’, cmap=’Blues’)
plt.xlabel(‘Predicción’)
plt.ylabel(‘Real’)
plt.title(‘Matriz de Confusión’)
plt.show()